Tokenization and Multilinguality
约 3091 个字 10 行代码 9 张图片 预计阅读时间 31 分钟
这一章的核心问题是:
Language model 看到的不是 raw text,而是 token sequence。那么 token 应该怎么定义?
Tokenization 看起来像一个预处理细节,但它会在模型训练之前就决定很多事情:
- 模型能直接观察到什么语言单位
- 同一段文本会变成多长的 sequence
- embedding matrix 需要多大
- 稀有词、拼写、错别字、多语言文本会不会被合理表示
- 不同语言用户在 token 数和 API 成本上是否公平
Important
Tokenizer 不是中性的。
它决定了 string 到 token IDs 的映射,也就决定了模型最底层的输入单位。
What is a token?
自然语言里没有唯一正确的切分方式。
例如:
可以按很多层级切分:
- Character / byte
W,e,',d, ...
- Morpheme
looked = look + -edMilky = milk + -y
- Word
- whitespace-separated words
- Phrase / entity
Milky Way可以作为一个整体实体
对语言学来说,word, morpheme, phrase 都有意义;但对 LM 来说,关键是选择一种可计算、可扩展、泛化好的单位。
Tokenizer in Language Models
对 language model 来说:
- Token
- 模型学习和预测的基本单位
- Tokenization
- 把 text 切成 tokens 的过程
- Vocabulary
- tokenizer 已知的 token 集合
- Token IDs
- vocabulary 中每个 token 的整数编号
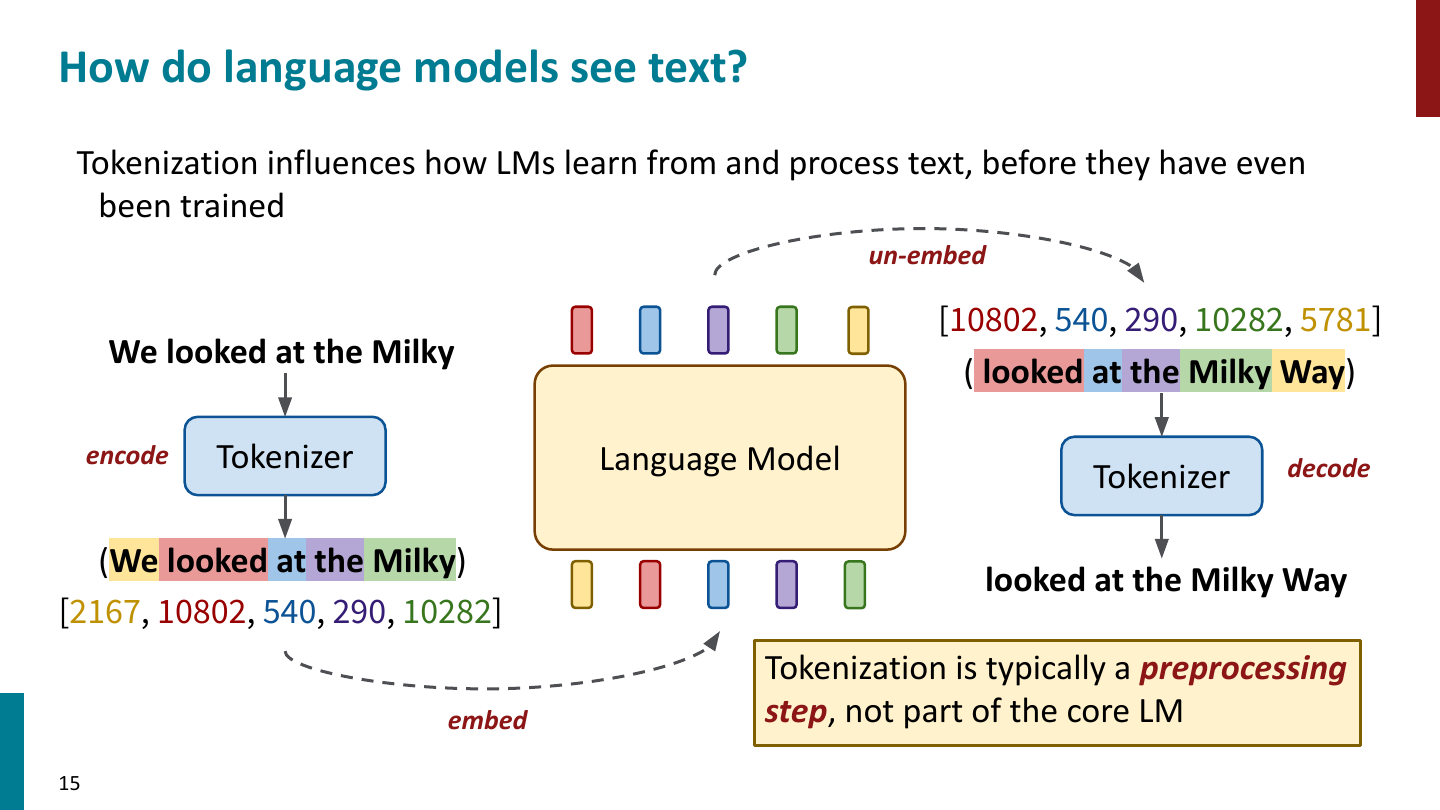
流程大致是:
模型不能直接读取 raw string,所以必须先有一个从 string 到 embedding sequence 的映射。
Tip
Tokenizer 通常在核心 LM 之外训练或定义。
因此 tokenization 会在模型训练前就影响模型的输入形状和学习难度。
Tokenization 主要影响两个效率维度:
- Sequence length
- token 越细,序列越长,attention 的计算和显存压力越大
- Vocabulary size
- token 越粗,词表越大,embedding matrix 和 output projection 越大
可以把 tokenization 看成一个 tradeoff:
Word Tokenization
最直接的方案是 word tokenization:
- 先按 whitespace 和 punctuation 切分文本
- 从 corpus 中选出 top \(V\) frequent words 作为 vocabulary
- 每个 word 大致对应一个 embedding
优点:
- token 通常有清楚的语义
- sequence length 相对短
- 一个 token 的 embedding 比较容易解释
但 word-level vocabulary 会遇到严重问题。
首先是 Zipf's law:
词的频率和它的 rank 大致成反比。
也就是说,少数高频词出现很多次,大量低频词只出现很少次。语言还在不断变化,新词、缩写、拼写变体都会出现。
第二个问题是 out-of-vocabulary (OOV):
- 测试时出现词表外单词怎么办?
- 用 rule-based preprocessing 可以修正一部分 typo,但不可靠
- 用
UNKtoken 会把很多不同词压成同一个符号,丢失内部结构
例如:
如果 importaNt 不在 vocabulary 里,word tokenizer 可能只能把它变成 UNK。模型看不到它和 important 之间的拼写关系。
Warning
Word tokenization 的核心缺陷是 coverage。
词表不可能完整覆盖语言里的所有词、拼写变体、新词和跨语言文本。
Character and Byte Tokenization
另一个极端是 character-level 或 byte-level tokenization。
- character-level:token 是 Unicode character
- byte-level:token 是 byte,例如 UTF-8 bytes
- byte 和 character 不完全一样:
- 一个 emoji 可能是 1 个 character,但占多个 bytes
- 一个中文字符通常也会占多个 UTF-8 bytes
优点:
- vocabulary 很小
- 几乎没有 OOV
- 模型可以直接观察 spelling 和 character composition
- 对 typo、罕见词、新词更有覆盖能力
缺点:
- sequence length 很长
- 更难直接形成 word / phrase 级别表示
- 对普通 Transformer 来说,长序列会显著增加计算成本
因此,character / byte tokenization 的问题不是表示不了文本,而是计算是否高效、模型是否容易从低层单位归纳出高层结构。
Subword Tokenization
Subword tokenization 试图折中:
高频词可以作为完整 token,低频词可以拆成多个 subword。
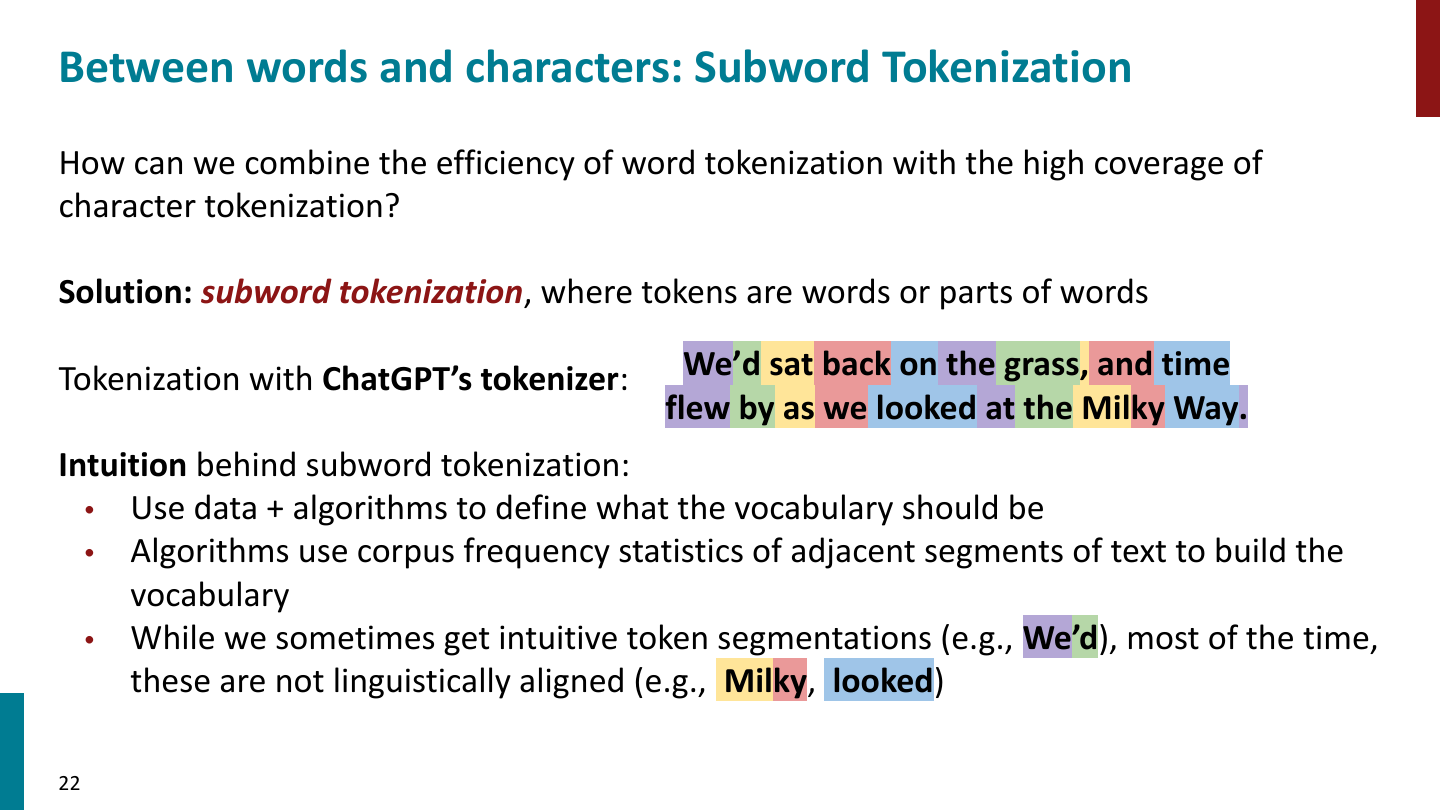
这种方法的直觉是:
- 用 corpus statistics 决定 vocabulary
- 高频片段更可能被合并成一个 token
- 低频词最坏也能退化成 byte / character sequence
- 在 coverage 和 efficiency 之间取得平衡
常见 subword 方法包括:
- Byte Pair Encoding (BPE)
- 从 byte / character 开始,反复合并最常见的相邻 token pair
- WordPiece
- 和 BPE 类似,但合并标准更接近最大化数据 likelihood
- Unigram Language Model
- 从较大的候选 subword 集合开始,逐步删掉 token
本章重点是 BPE,因为它简单、确定、实现高效,也是现代 LLM 中非常常见的 tokenizer family。
Byte Pair Encoding
BPE 训练需要两个输入:
- training corpus \(D\)
- desired vocabulary size \(N\)
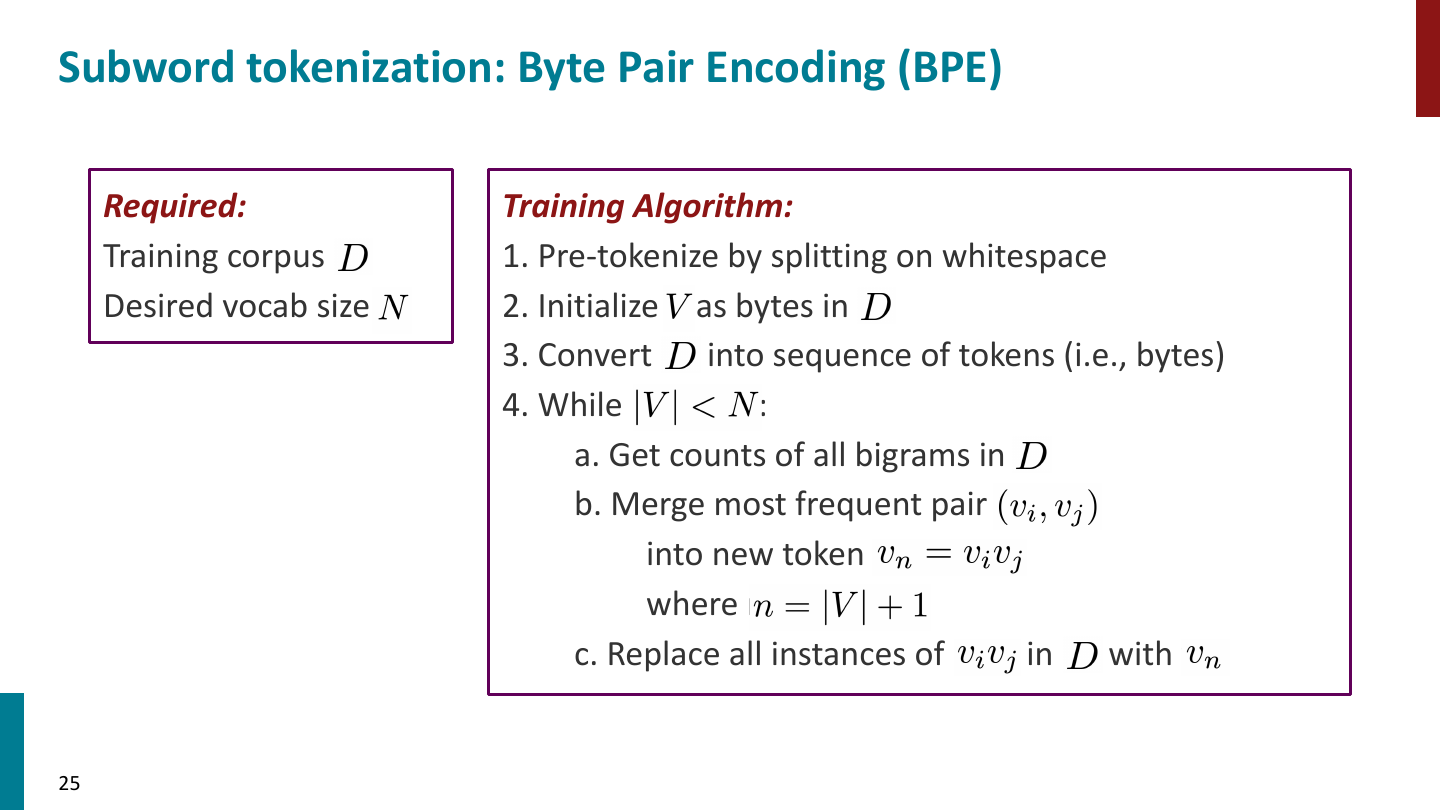
训练过程可以概括为:
- 对 corpus 做 pre-tokenization,例如先按 whitespace 切分
- 初始化 vocabulary \(V\),包含 corpus 中出现的 bytes
- 把 corpus 表示成 byte sequence
- 当 \(|V| < N\) 时重复:
- 统计 corpus 中所有相邻 token pair 的频率
- 找到最高频 pair \((v_i, v_j)\)
- 合并成新 token \(v_n = v_i v_j\)
- 把 corpus 中所有这个 pair 替换成新 token
用公式写就是:
其中:
每次 merge 后,corpus 的 tokenization 都会变化,所以 bigram frequency table 也要重新计算或增量更新。
Important
BPE 学到的不是语言学意义上的 morpheme。
它学到的是在训练语料中高频、可压缩的相邻片段。
BPE example intuition
假设语料是:
pre-tokenize 后可以用 _ 表示 word boundary:
初始化时 token 是 bytes,例如:
如果 _ + p 出现最多,就先合并为 _p;如果 c + k 高频,就合并为 ck;之后可能继续合并出_pe , _pi , _pick等 token。
这个过程会把频繁出现的字符序列压缩成更大的 subword。
Test-time BPE
训练结束后,BPE tokenizer 保存的是一个 ordered merge list。
在 test time tokenize 一个新词时:
- 先把输入拆成 bytes
- 按训练得到的 merge list 顺序应用 merge
- 不能 merge 的部分保持为更小 token
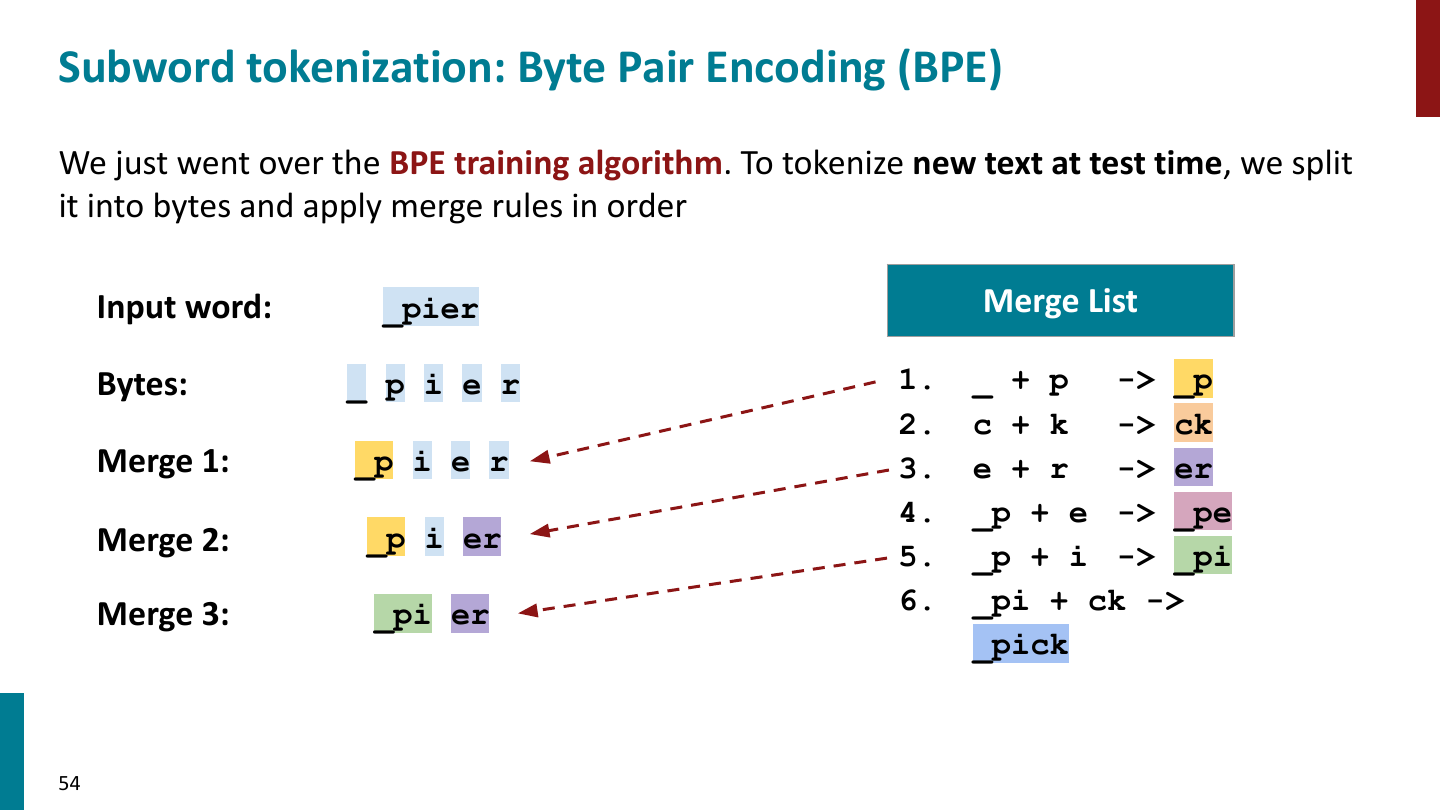
例如 _pier 可能会经历:
因为 merge list 中可能有_ + p -> _p ,e + r -> er , _p + i -> _pi,但没有足够规则把整个 _pier 合成一个 token。
Tip
BPE 的强项是 deterministic compression。
它避免了 word-level OOV,同时比 character / byte sequence 短得多。
Whitespace Is Not Universal
许多 tokenizer 会先做 whitespace pre-tokenization,但这并不总合理:
- 中文、日文、泰文等语言不一定用 whitespace 分词
- multi-word expression 可能跨越 whitespace,例如
on the other hand - 有些语言中的 word boundary 本身就不容易用简单规则定义
SentencePiece 的重要点是:
- 它是 tokenizer library,不是单一算法
- 可以实现 BPE 和 Unigram LM
- 把 whitespace 当成 vocabulary 中的基本符号处理
- 常用于 T5, Llama 2, XLM-R, Gemma 等模型
SuperBPE 则进一步尝试放松 whitespace 限制,先学 subword,再学习跨 whitespace 的更大 token,以减少词表或推理成本。
Where Subword Tokenization Breaks
BPE 是很强的工程折中,但它并没有解决所有问题。
Spelling
Subword model 看到的是 subword chunks,不是 character sequence。
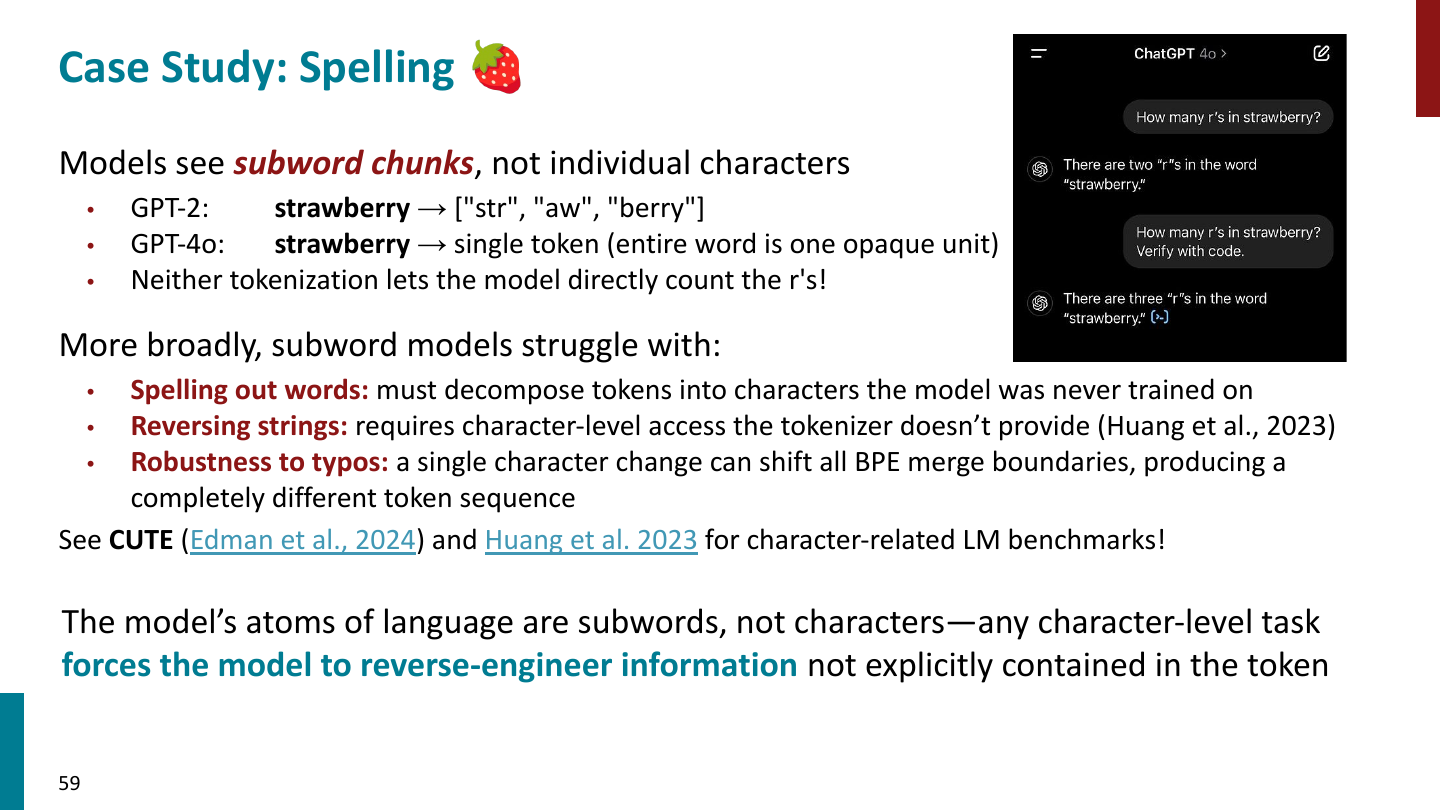
例如 strawberry:
- GPT-2 可能看到的是
str,aw,berry - 某些新 tokenizer 可能直接把整个
strawberry当成一个 token
这两种情况都不等价于模型直接看到了:
因此模型在 character-level tasks 上会遇到天然困难:
- 数某个字母出现几次
- 拼写一个词
- 反转字符串
- 判断 typo
Important
如果 tokenizer 没有把 character 暴露给模型,模型就必须从 subword embedding 中反推出 character 信息。
这不是它训练时最自然的输入单位。
一个 typo 还可能改变后续所有 BPE merge boundary,使 token sequence 完全不同,从而影响鲁棒性。
Glitch Tokens
Glitch token 来自 tokenizer 和 LM 训练数据的不匹配。
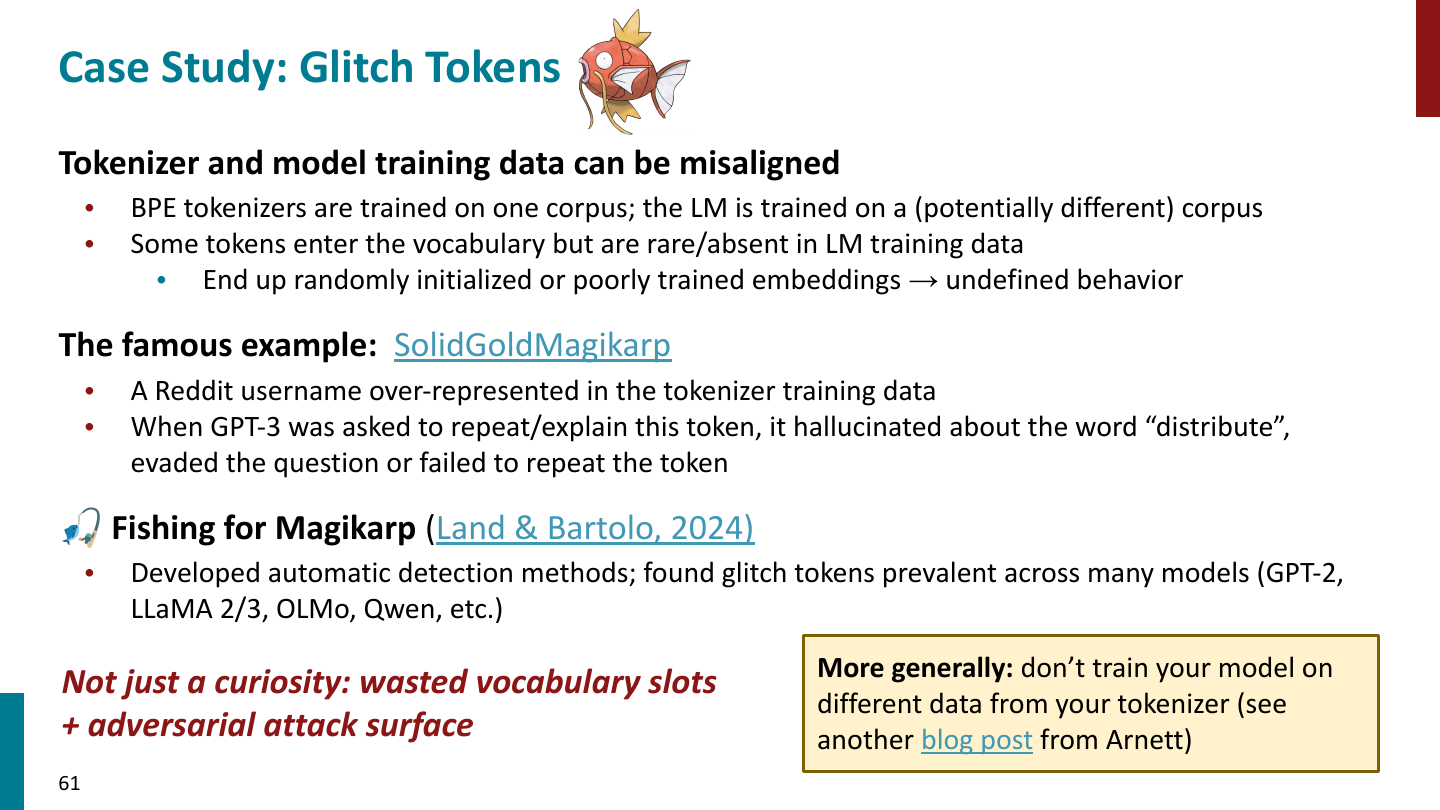
典型情况是:
- BPE tokenizer 在一个 corpus 上训练
- LM 在另一个 corpus 上训练
- 某些 token 因为 tokenizer corpus 中高频而进入 vocabulary
- 但这些 token 在 LM training corpus 中很少出现,甚至几乎没有出现
- 对应 embedding 训练不足,行为可能异常
著名例子是 SolidGoldMagikarp:
- 它因为某些数据分布进入 tokenizer vocabulary
- 但语言模型训练中几乎没有足够上下文学习它的含义
- 模型面对它时可能无法稳定复述或解释
这不只是趣事,还会带来实际问题:
- 浪费 vocabulary slots
- 引入未充分训练的 embedding
- 形成 adversarial attack surface
Warning
Tokenizer training data 和 LM training data 最好保持一致或至少分布接近。
否则 tokenizer 可能把模型几乎没学过的字符串做成独立 token。
Why Multilinguality Matters
世界上有超过 7000 种被记录的语言,而英语只是其中一部分:
- 大约 20% 的世界人口会说英语
- native English speakers 只占更小比例
- 现实 NLP 需求包括 translation, cross-lingual retrieval, code-switching 等
但互联网语料极不均衡:
- Common Crawl 中英语比例很高
- 很多 low-resource languages 在网页语料中占比极小
- labeled data, tools, benchmarks 也集中在 high-resource languages
因此 multilingual NLP 的目标不是“让英语模型顺便支持别的语言”,而是让模型在不同语言上都能可靠、低成本地工作。
Multilingual Language Modeling
Multilingual LM 在架构上并不特殊:
- 仍然可以是 Transformer encoder / decoder / encoder-decoder
- 仍然使用 MLM 或 CLM 等训练目标
- 主要区别是 tokenizer 和 LM training data 使用多语言 corpus
流程可以写成:
Cross-lingual Transfer
Multilingual LM 的一个重要现象是 cross-lingual transfer:
模型只在一种语言的 labeled data 上 finetune,却能在另一种语言上 zero-shot 使用。
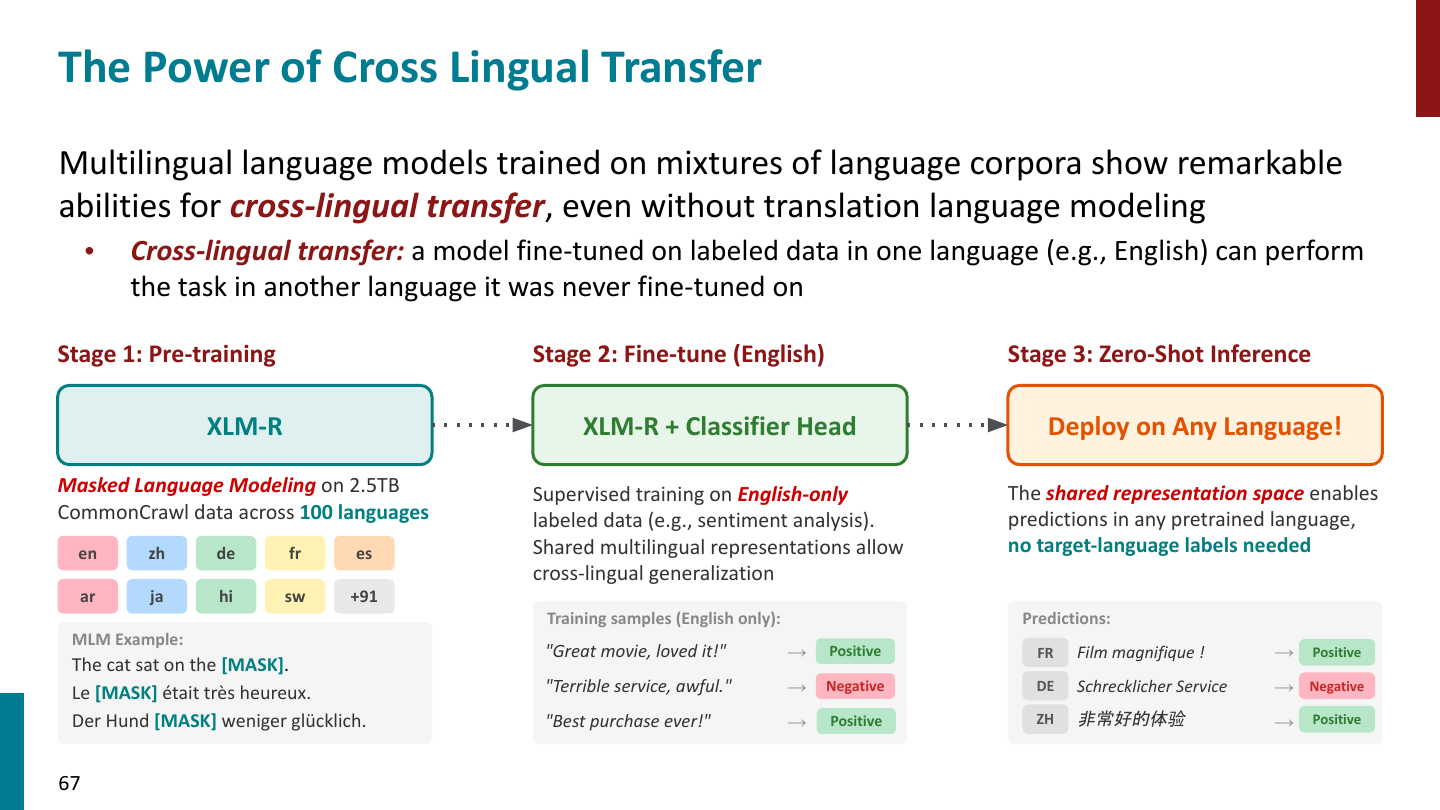
例如:
- 预训练时,XLM-R 在多语言语料上做 masked language modeling
- Finetune 时,只用英语 sentiment labels
- 推理时,把模型用于法语、德语、中文等语言
直觉是:多语言预训练让模型学到某种 shared representation space。只要不同语言的表达在这个空间中对齐,英文监督信号就可能迁移到其他语言。
Vocabulary Overlap
Vocabulary overlap 会影响 cross-lingual transfer。
如果不同语言之间有共享 token:
- 共享 token 的 embedding 可以成为跨语言桥梁
- 即使是 false friends,也可能帮助模型建立跨语言 representation
- 更高 overlap 往往有利于 transfer,但效果依赖具体任务
但还有另一个问题:每种语言都需要足够的 vocabulary allocation。
如果把很多语言塞进固定大小 vocabulary:
- high-resource language 可能占据大量 token
- low-resource language 可能被切得更碎
- 增大 vocab 可以缓解覆盖问题,但会增加 embedding 和 softmax 成本
The Curse of Multilinguality
Cross-lingual transfer 听起来像解决低资源语言问题的捷径,但并不完全。
Curse of multilinguality 指的是:
增加语言数量一开始有助于 transfer,但在固定模型容量下,语言继续增加会导致性能下降。
原因包括:
- 模型参数有限
- tokenizer vocabulary 有限
- 每种语言分到的训练容量和表示空间有限
- 高资源语言和低资源语言之间会竞争模型容量
因此,多语言建模不是简单地“加入更多语言”。它需要在语言覆盖、模型容量、数据采样、tokenizer design 之间做权衡。
Tokenization Fairness
多语言场景下,tokenization 本身会引入不公平。
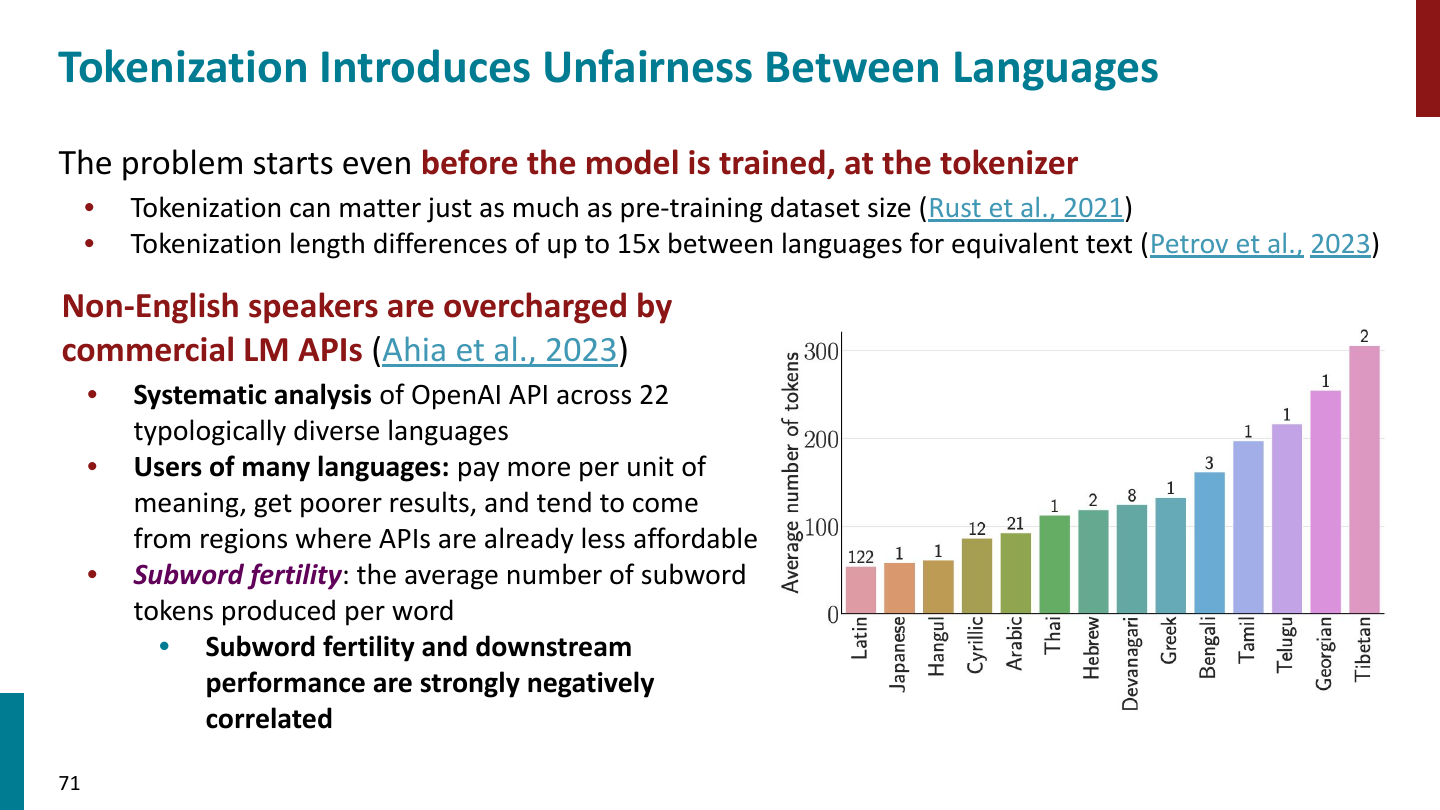
同一段语义等价的文本,不同语言可能被切成完全不同数量的 tokens。
这会造成几个后果:
- Cost unfairness
- 按 token 计费的 API 中,某些语言表达同样意思要付更多钱
- Context unfairness
- 同样的 context window,某些语言能放入的信息更少
- Quality unfairness
- token sequence 更长、更碎时,模型更难建模,性能可能下降
一个常用指标是 subword fertility:
subword fertility 越高,说明平均每个 word 被拆成更多 subword。研究中常观察到它和 downstream performance 有负相关。
Important
多语言 tokenization 的公平性问题不是训练之后才出现的。
它在 tokenizer 阶段就已经开始了。
Revisiting Character and Byte Models
多语言建模也让 character / byte tokenization 重新变得有吸引力。
原因是:
- byte / character vocabulary 可以覆盖几乎所有语言
- 未见过的语言也可以被表示
- 不容易出现 OOV
- 不会因为稀有字符串进入 vocabulary 而产生同样形式的 glitch token
- 对 spelling 和 character-level manipulation 更自然
问题仍然是 sequence length。
因此新的方向通常不是简单回到普通 character Transformer,而是设计更高效的 byte-level architecture。
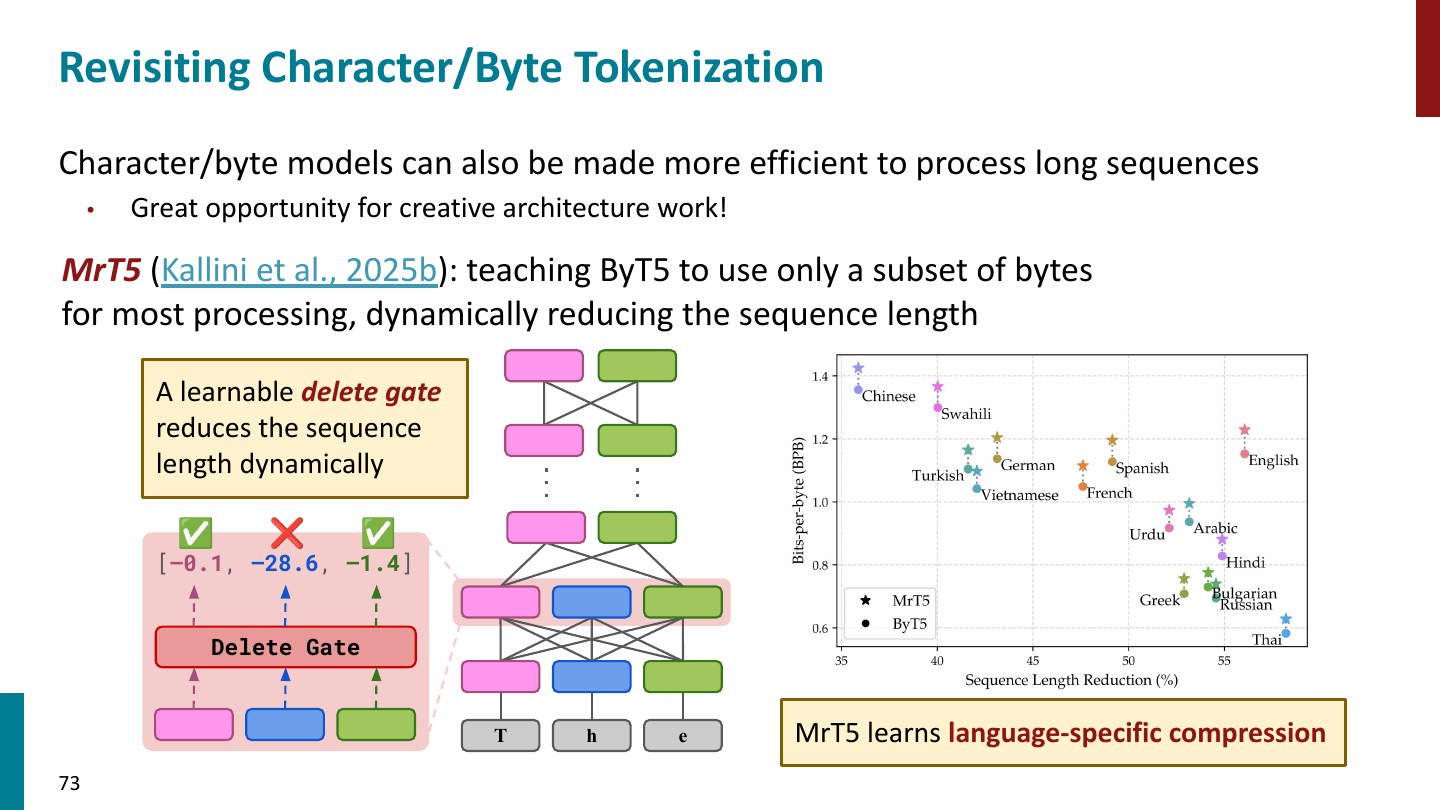
例子包括:
- CANINE
- character-level counterpart to mBERT
- ByT5
- byte-level seq2seq model
- MrT5
- 动态删除部分 bytes,让模型只在必要位置保留长序列
- Byte Latent Transformer / HAT / H-Nets
- 用 hierarchical 或 latent tokenization 思路降低 byte-level 建模成本
可以把这些方向理解成:
Tip
Byte-level model 并不是放弃 tokenization。
更准确地说,它把“什么是有用的语言单位”从固定 tokenizer 中移到模型结构和训练过程中学习。
Summary of Tokenization and Multilinguality
- Tokenization 决定 LM 的基本输入单位,不只是预处理细节
- Word tokenization 语义清楚、序列短,但有 OOV 和 long-tail 问题
- Character / byte tokenization 覆盖强、词表小,但 sequence length 很长
- Subword tokenization 在 coverage 和 efficiency 之间折中
- BPE 从 byte 开始,反复合并最高频相邻 token pair,最终得到 merge list
- BPE 没有 OOV,但会在 spelling、typo、character-level tasks 上暴露问题
- Glitch tokens 往往来自 tokenizer corpus 和 LM training corpus 的不匹配
- Multilingual LM 依赖多语言 tokenizer 和多语言预训练,能产生 cross-lingual transfer
- Vocabulary overlap 有利于跨语言迁移,但固定容量下会出现 multilinguality tradeoff
- Tokenization 会造成语言间 token 数、API 成本和上下文利用的不公平
- Character / byte models 重新受到关注,因为它们更适合覆盖多语言和字符级现象,但需要更高效的架构